Hoofdstuk 9
Maatschappelijke krachten rondom AI
30 min lezen
AI beïnvloedt niet alleen je werk, maar ook de maatschappij als geheel. Dat varieert van degenen van wie het werk (illegaal) gebruikt wordt om modellen te trainen tot de invloed van generatieve AI-output en sociale media algoritmes op politiek of op het welzijn van individuen. De eigenaars van de technologie kunnen meer en meer invloed uitoefenen om anderen hun wil op te leggen.
#9.1Inleiding
In dit hoofdstuk gaan we in op een aantal maatschappelijke aspecten van generatieve AI. Het gaat daarbij om aspecten die gaan over het maken van taalmodellen, over de wijze waarop AI kan polariseren of juist verbindingen kan leggen en over de macht van bedrijven die AI-technieken maken en aanbieden.
#9.2Databronnen en copyrightproblemen rondom LLM’s
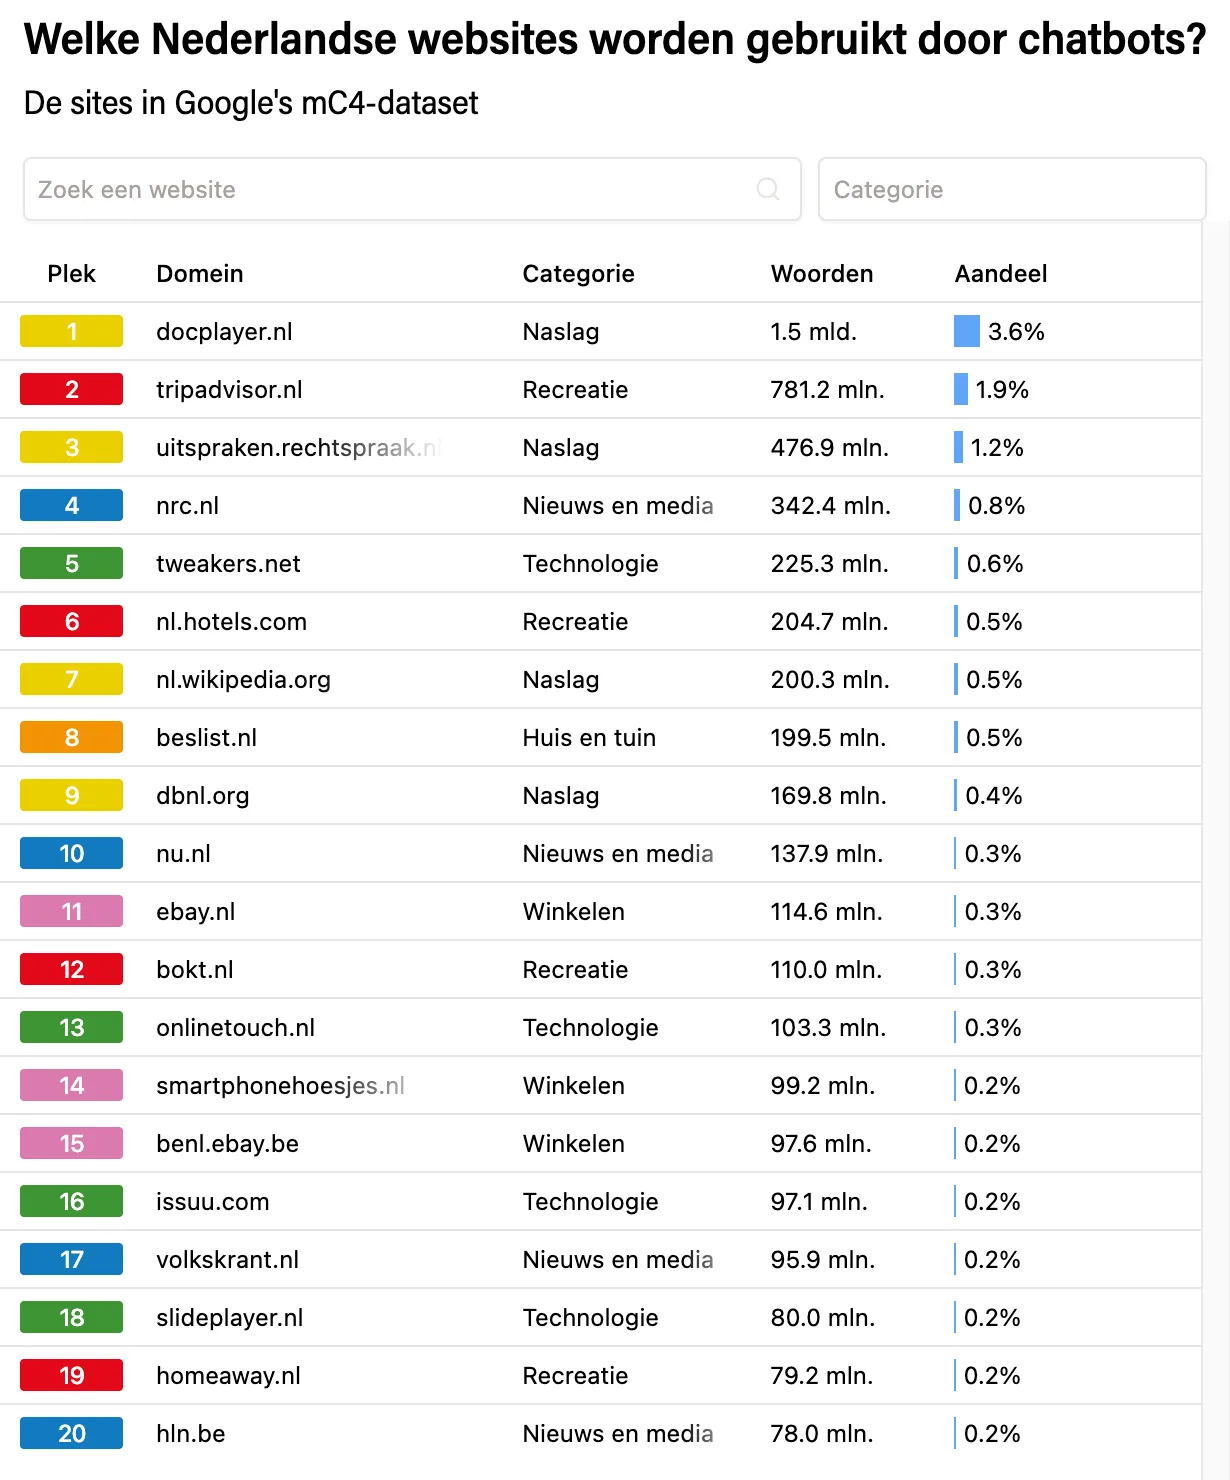
Voor het maken van taalmodellen zijn grote hoeveelheden data nodig, maar het is vaak onduidelijk hoe de bedrijven die LLM’s maken, aan die data komen. Eerder waren bedrijven vrij transparant over de gegevensbronnen die ze inzetten om hun modellen te trainen. Een groot deel van de Nederlandse teksten die wordt gebruikt voor het trainen van AI-modellen, zoals ChatGPT, is bijvoorbeeld afkomstig uit de zogeheten Common Crawl-database (mC4-dataset) die functioneert als een representatie van het internet. De Groene Amsterdammer en Data School (Hofman & Veerbeek, 2023) analyseerden deze bronnen.
Uit deze analyse kwamen drie opvallende categorieën naar voren:
- De grootste bron van informatie in de dataset is de website DocPlayer. Deze website is opgezet door een Russische ondernemer en verzamelt automatisch documenten die online verschijnen. De documenten zijn vaak zonder toestemming hergebruikt, wat deze bron juridisch en ethisch problematisch maakt. Daarnaast bevat de site ook veel persoonsgegevens en gevoelige gegevens. Zo zijn er belastingaangiften en sollicitatiebrieven in gevonden. Dat maakt het gebruik van deze bron bijzonder omstreden.
- Belangrijke andere bronnen zijn de artikelen van kranten en journalistieke bladen. Dit zijn journalistiek hoogwaardige bronnen, maar de uitgeverijen hebben nooit toestemming gegeven voor dit gebruik. De bouwers van de LLM maken kosteloos gebruik van data waarvoor uitgeverijen aanzienlijke investeringen in tijd, geld en journalistieke arbeid hebben gedaan. Uitgeverijen onderzoeken daarom op juridische wijze hoe ze deze situatie kunnen veranderen.
- Veel van de bronnen waarop de LLM’s getraind zijn, zijn juist van lage kwaliteit waarbij de betrouwbaarheid ernstig ter discussie staat. Bijvoorbeeld de reviews die mensen geven in webshops. Daarnaast blijkt ook de nazistische complotwebsite Stormfront een van de gebruikte bronnen te zijn, die wat betreft grootte in de C4-bronnenlijst maar één plek lager staat dan RTL Nieuws.
Techbedrijven zijn sinds kort heel gesloten over de bronnen die ze gebruiken omdat de juridische basis daarvan ter discussie staat. Daarbij spannen schrijvers bijvoorbeeld rechtszaken aan tegen de grote generatieve AI-bedrijven omdat ze op zijn minst gecompenseerd willen worden, als het hergebruik van hun werk al niet illegaal is. De rechtszaken hierover, bijvoorbeeld in Amerika, worden door verschillende rechters nog steeds verschillend beoordeeld waardoor er tot nu toe nog geen duidelijk antwoord is op dit probleem (Visser, 2025).
Toch gaan de generatieve AI-bedrijven door met het verzamelen van data om modellen te verbeteren, want ze concurreren natuurlijk met elkaar. Daarom blijven ze ook controversiële databronnen gebruiken zoals illegale boekensites Anna’s Archive en LibGen (Pontefract, 2025). Hierover lopen meerdere rechtszaken tegen de grote taalmodelbouwers (Spinner, 2025). Maar ook data van sociale mediaplatforms worden meer en meer gebruikt. Zo gaat Elon Musk data van X (voorheen Twitter) inzetten voor de ontwikkeling van zijn modellen (POLITICO, 2025) en wil Meta-topman Mark Zuckerberg de data van WhatsApp, Facebook en Instagram hiervoor benutten (Heikkiläarchive, 2024). Maar bedrijven stappen ook steeds meer over op bronnen die juridisch juist minder problematisch zijn. Zo sluit OpenAI bijvoorbeeld overeenkomsten met uitgeverijen om hun data te gebruiken (OpenAI, 2023). En gebruikt Adobe voor hun generatieve AI Firefly alleen eigen stockmateriaal.
#9.3Trainen van AI-modellen door mensen
Hoewel generatieve AI vooral een technische ontwikkeling lijkt, spelen mensen daarin toch een belangrijke rol. Om de modellen te trainen zoals we beschreven in hoofdstuk 5, is er veel menselijke arbeid nodig, vooral door zogeheten ‘datalabelers’. Dit zijn mensen met specifieke expertise in bijvoorbeeld taal of een bepaald inhoudelijk vakgebied, die ingezet worden tijdens de fase van het supervised and reinforcement learning: ze beoordelen teksten of beelden en labelen dat.
Volgens schattingen zijn er wereldwijd miljoenen mensen actief in dit werk. Op zichzelf is dat niet problematisch, maar journalisten zoals Martijn (2023) en Van Bergeijk (2025) uiten wel serieuze zorgen over de begeleiding en beloning van deze werkers. Veel datalabelers worden volgens hen onderbetaald en langdurig blootgesteld aan geestdodend en psychisch belastend werk, zoals het beoordelen van grote hoeveelheden gewelddadige teksten en beelden.
Daar staat voor hen volgens de journalisten weinig tegenover: geen psychische hulp, geen vast dienstverband en geen passende financiële beloning. De meeste datalabelers werken via een constructie waarbij datalabelingbedrijven hen inhuren op uur- en stuksbasis tegen een laag tarief. De vergoeding varieert van twee euro per uur in Afrikaanse landen tot dertig euro per uur in landen als Nederland. Het werk is heel onregelmatig. Datalabelingbedrijven huren tijdelijk grote aantallen werkers in wanneer ze opdrachten krijgen, maar zodra een opdracht afgerond is, kan er langere tijd geen werk zijn. Wie volgens een bedrijf te weinig, niet snel of nauwkeurig genoeg werkt, raakt vaak zonder uitleg direct zijn contract kwijt. Kortom, het trainen van LLM’s leunt zwaar op menselijke arbeid, terwijl de arbeidsvoorwaarden en rechten van deze werkers vaak minimaal zijn.
Dit beloningssysteem en deze omstandigheden beschouwen we vanuit het Europees perspectief als uitbuiting. Vanuit de democratische en sociale waarden van Nederland en de EU zijn de rechten en het welzijn van werknemers een primair aandachtspunt. Vanuit perspectieven van andere politieke invloedssferen gelden blijkbaar vaak andere waarden.
Dit vormt daarmee een enorm dilemma voor Europese bedrijven die taalmodellen willen ontwikkelen. Europese bedrijven willen naar verwachting modellen trainen op basis van arbeidsvoorwaarden die verantwoord zijn. Maar dat maakt het trainen van modellen natuurlijk duurder en geeft in competitieve zin een achterstand op landen of bedrijven die het niet zo nauw nemen daarmee. De vraag is hoe dat gat overbrugd zou moeten worden.
#9.4Algoritmes, AI, sociale media, discriminatie, filterbubbels, extremisme
Zeker als burger krijg je met AI te maken. Bijvoorbeeld in de manier waarop je geïnformeerd wordt door sociale media, hoe overheidsdiensten beslissingen nemen of hoe je privacy wordt beschermd. AI beïnvloedt daarmee niet alleen je toekomstige werk, maar ook je maatschappelijke positie, je rechten en je kansen. Het vraagt dus om reflectie op meerdere niveaus: als student, professional en burger.
Eén van de belangrijkste aspecten daarbij is hoe algoritmes in combinatie met AI, de informatie die je te zien krijgt en de mensen die je leert kennen, beïnvloedt. En dat beïnvloedt op zijn beurt je mening en beeld van de wereld. En dat gaat niet alleen om relatief onschadelijke informatie of mensen die geïnteresseerd zijn in een bepaald muziekgenre, games of postzegelverzamelen. Nee het gaat veel verder omdat het invloed heeft op diepgevoelde normen en waarden zoals geluk, welzijn, zelfbeeld, angst, empathie, gelijkheid, vrienden of vijanden en democratische waarden. Het is essentieel om te begrijpen hoe technologiebedrijven algoritmes maken die je in een steeds nauwer en extremer keurslijf van informatie en denkramen kunnen manoeuvreren en die maatschappelijk tot steeds extemere standpunten kunnen leiden door deze extreme standpunten te normaliseren.
#9.5.1Hoe algoritmes je aandacht vasthouden
Sociale media platforms zijn zo ontworpen dat je zo lang mogelijk blijft scrollen, kijken en liken. Meer tijd op het platform betekent meer mogelijkheden om advertenties te tonen, wat de belangrijkste inkomstenbron is voor de meeste platforms. De algoritmes bij online winkels of sociale media platforms zijn ontworpen om jouw gedrag te analyseren en steeds voor jou aantrekkelijkere content te laten zien. Ook zonder AI kunnen platforms je gebruikersvoorkeuren inschatten, maar AI maakt dit proces veel effectiever en verfijnder. Content die goed past bij jouw voorkeuren, krijgt hierin de voorrang. Maar voorl sensationele content blijkt de aandacht goed vast te houden, waardoor wat je soms te zien krijgt extreem kan zijn. Denk aan misleidende goedkopen aanbiedingen, gewelddadige content, extreme meningen of gevaarlijke uitdagingen.
In het algemeen werken de algoritmes op basis van verzamelde data en de patronen daarin. Die analyseren de betrokkenheid van jou als gebruiker en filteren berichten. De doelstelling hierachter is niet per se op jou gericht om je zoveel mogelijk plezier te geven, maar vooral om je aandacht zo lang mogelijk vast te houden.
Dataverzameling (Input) - alles wat je doet op het platform is data voor het algoritme:
- Interacties: welke posts like je, deel je, of becommentarieer je? Op welke links klik je?
- Kijktijd: hoe lang kijk je naar een video of afbeelding? Scroll je snel voorbij of stop je?
- Connecties: wie zijn je vrienden/volgers? Wat vinden zij leuk en delen zij?
- Profielinformatie: je leeftijd, locatie, interesses die je hebt opgegeven.
- Zoekgedrag: Waar zoek je naar binnen het platform?
- Soms ook data van buiten het platform, via cookies en trackers.
- Soms ook data van je telefoon, zoals je contacten, je gps-locatie of je fotogalerij.
Patroonherkenning en profilering - het algoritme analyseert continu al deze data om een gedetailleerd profiel van jou op te bouwen. Het leert:
- Welke onderwerpen je interessant vindt (politiek, sport, muziek, kattenvideo's, specifieke hobby's, specifiek type mensen).
- Welke meningen of invalshoeken je waarschijnlijk deelt of waardeert of waar je juist negatief op reageert, zodat je ook weer langer blijft hangen en reageren.
- Welke accounts (personen, nieuwsbronnen, groepen) je volgt.
- Welk type content (video, tekst, afbeelding) je het meest boeit.
Voorspelling van betrokkenheid (engagement).
Op basis van je profiel voorspelt het algoritme bij elk stukje potentiële content (een post van een vriend, een nieuwsartikel, een advertentie, een virale video) hoe waarschijnlijk het is dat jij erop reageert (liken, reageren, delen, lang kijken). Content met een hoge voorspelde betrokkenheid krijgt prioriteit.
Personalisatie en filtering (de kern van de bubbel):
- Prioritering: het algoritme vult jouw feed met de content waarvan het denkt dat jij die het leukst zult vinden of het meest mee zult interacteren. Dit is vrijwel altijd content die aansluit bij je eerdere gedrag, persoonskenmerken en voorkeuren. Maar kan dus ook een tegengestelde of extreme mening zijn, zodat je juist reageert.
- Filtering: content waarvan het algoritme voorspelt dat je er weinig mee zult doen, bijvoorbeeld omdat je het onderwerp saai vindt of dat het van een onbekende bron komt, wordt lager geplaatst of helemaal niet getoond.
De stappen die je hierboven leest, worden overal online toegepast. De gegevens worden niet verzameld om bepaalde hypothesen te testen zoals bij klassieke statistiek, maar er wordt naar patronen gezocht die volgen uit de data zelf. In dit verband worden ook wel de termen AI en Big Data met elkaar verward.
Algoritmes kunnen ook confronterend zijn wanneer ze voorkeuren of persoonlijkheidskenmerken voorspellen waar je je niet van bewust bent, of die je liever verborgen houdt. Zo vertellen jongeren in het boek Filterworld, van de Amerikaanse journalist en cultuurcriticus Kyle Chayka (2024) dat het TikTok-algoritme vaak eerder ‘doorhad’ dat ze wellicht queer waren, dan zijzelf. Sommige gebruikers vragen zich zelfs af of hun voorkeuren wat betreft hobby’s of interesses wel echt van henzelf zijn, of juist mede gevormd worden door de algoritmes die hen voortdurend sturen. The New Yorker (2022) noemt dit fenomeen ‘algorithmic anxiety’: het ongemakkelijke gevoel dat algoritmes je identiteit beïnvloeden.
Toch zitten algoritmes er ook regelmatig naast. Wanneer het systeem weinig informatie over jou heeft of je zet gepersonaliseerde advertenties uit, dan vult het dit op met algemene aannames. Bijvoorbeeld op basis van leeftijd, genderidentiteit of locatie. Daardoor kan het gebeuren dat je als vrouw van rond de dertig advertenties krijgt voor babyproducten, ook al heb je daar geen interesse in. Of dat je als man vooral auto- of sportreclames ziet, puur vanwege stereotypen. Zulke voorspelstrategieën kunnen niet alleen irritant zijn, maar ook beperkend of vervreemdend werken.
#9.5.2Echokamers en filterbubbels
Doordat bijna alle platforms algoritmes inzetten om gebruikers zo lang mogelijk actief te houden worden gebruikers uiteindelijk automatisch geclusterd in groepen die veel op elkaar lijken. Daardoor kom je terecht in zogenaamde echokamers of filterbubbels.
Dit proces werkt via een versterkingslus die steeds krachtiger wordt. Als jij voornamelijk reageert of kijkt naar content en personen die jouw wereldbeeld bevestigen, leert het algoritme dat je dit soort content waardeert. Het zal je er vervolgens nóg meer van laten zien. Hierdoor worden je bestaande overtuigingen constant versterkt en herhaald. Je raakt gevangen in wat experts een echokamer noemen.
Tegelijkertijd word je systematisch minder blootgesteld aan diversiteit of andere perspectieven. Omdat het algoritme content wegfiltert die waarschijnlijk niet direct jouw like of share krijgt, zie je steeds minder afwijkende meningen, andere perspectieven, of informatie die jouw bestaande ideeën uitdaagt. Je komt zo terecht in een filterbubbel, een gepersonaliseerd informatie-universum dat je onbewust afschermt van andere gezichtspunten.
Het algoritme versterkt ook een natuurlijke menselijke neiging. Mensen verbinden zich van nature graag met gelijkgestemden, wat op zichzelf niet schadelijk hoeft te zijn. Vind je in je offline leven bijvoorbeeld geen lotgenoten van een ziekte die je hebt, geen huisgenoot die eindeloos wil praten over tektonische platen, of niemand die je liefde voor een obscure Zweedse voetbalclub deelt? Dan vind je die online wel. Het systeem speelt hier handig op in. Het toont je enerzijds vaker content van de vrienden en connecties waarmee je het meest interacteert en anderzijds juist onbekenden die veel op jou lijken. Dat zijn meestal precies degenen die jouw mening al delen. Zo ontstaat er een spiraal waarin je digitale wereld steeds meer lijkt op een bevestiging van wat je al dacht en voelde.
#9.5.3Extremisme en polarisatie
Al deze mechanismen zijn niet zonder gevaren. Natuurlijk, als het gaat om met gelijkgestemden ervaringen uit te wisselen over tuinieren is er niet veel aan de hand. Maar het kan vanuit politiek en maatschappelijk oogpunt ook leiden tot polarisatie, extremisme en radicalisering. Hier ligt een combinatie van psychologische en sociale factoren aan ten grondslag (Barberá, 2020; Lim & Bentley, 2022).
Het begint vaak met het zogeheten bevestigingsvooroordeel (confirmation bias): jouw natuurlijke neiging om informatie te zoeken die je bestaande overtuigingen bevestigt. Je begaat daarmee in feite een belangrijke logische redeneerfout, namelijk dat je daarmee alternatieve verklaringen van wat je ervaart gaat uitsluiten. Zo ging het ook met die huisgenoot die geen zonnebrandcrème meer wil smeren omdat ze denkt dat het slecht voor je huid is. Ze zag er eerst een enkele TikTok over, bleef er lang naar kijken, regeerde op comments en raakte overtuigd. Vervolgens kreeg ze meerdere TikToks te zien die dezelfde boodschap hadden (en dus niet: TikToks die een tegenovergestelde of ander boodschap hebben!) en denkt ze: zie je wel, zonnebrandcrème is inderdaad slecht voor je. In een echokamer krijg je vrijwel alleen maar dit soort bevestigende informatie voorgeschoteld. Elke like die je geeft, elke post die je deelt, elk artikel dat je leest, lijkt je gelijk te geven. Hierdoor voelt je overtuiging steeds sterker en zekerder aan.
Tegelijkertijd zorgt het constant zien en horen van dezelfde meningen ervoor dat deze ideeën steeds normaler en geloofwaardiger lijken. Dit staat ook wel bekend als het ‘illusory truth effect’: door herhaling wordt wat misschien eerst een twijfelachtige gedachte was, een geaccepteerde waarheid voor je. Omdat afwijkende meningen of kritische geluiden systematisch worden weggefilterd of genegeerd, worden de heersende ideeën binnen de echokamer nooit echt uitgedaagd. Je voelt geen noodzaak om je eigen argumenten te verfijnen of rekening te houden met nuances of complexiteit. Dit leidt tot simplificatie en verharding van standpunten.
Een bijzonder krachtig effect is groepspolarisatie. Wanneer jij en gelijkgestemde mensen met elkaar discussiëren, neig je ertoe om daarna een extremere versie van je oorspronkelijke standpunt in te nemen. Dit gebeurt omdat je nieuwe argumenten hoort die je standpunt ondersteunen, omdat je je wilt conformeren aan wat je ziet als de groepsnorm (die vaak iets extremer is dan het individuele gemiddelde), en omdat je je wilt onderscheiden als een goed groepslid door een wat sterkere mening te uiten.
Gedeelde overtuigingen creëren bovendien een gevoel van saamhorigheid en sociale validatie. Je groepsidentiteit raakt sterk verbonden met deze overtuigingen, waardoor het moeilijker wordt om van mening te veranderen zonder het gevoel te hebben de groep en een deel van jezelf te verraden. Om de eigen groepscohesie te versterken, worden mensen of groepen met afwijkende meningen vaak negatief, simplistisch of zelfs als vijandig afgeschilderd. Dit wij-versus-zij-denken vermindert empathie, ontmenselijkt de ander soms, en maakt het makkelijker om extremere standpunten over de ander in te nemen.
Maar het zijn niet alleen de gebruikers zelf te die met steeds extremere standpunten komen. Juist de door de platforms ontworpen algoritmes versterken dit. Platforms zoals YouTube of TikTok kunnen gebruikers via hun aanbevelingsalgoritmes naar steeds extremere content leiden. Dit proces wordt algoritmische radicalisering genoemd (O’Callaghan et al., 2015), waarbij algoritmes gebruikers naar steeds radicalere content sturen om betrokkenheid te behouden. Dit gebeurt niet noodzakelijk met kwade bedoelingen, maar als bijproduct van algoritmes die ontworpen zijn om gebruikersbetrokkenheid te maximaliseren.
Hoewel de hierboven beschreven mechanisme niet een-op-een samenvallen met AI en zeker niet met generatieve AI, is het wel heel belangrijk om ze te kunnen herkennen in je professionele en persoonlijke leven.
Je moet je ervan bewust zijn dat de manier waarop de stap personalisatie en filtering (de kern van de bubbel) wordt bepaald en ontworpen is, in de handen ligt van bedrijven en dus van mensen. Die mensen zijn de eigenaren en managers van bedrijven die de software leveren en er hun geld mee verdienen. Het is een bewuste keuze van hen om deze algoritmes zo te maken dat je er als eindgebruiker zoveel mogelijk weer terugkomt, om je vervolgens op jouw toegesneden reclame te kunnen laten zien. In feite beslissen zij voor jou in belangrijke mate hoe jij denkt en je gedraagt. Die bedrijven hebben dus een hele grote verantwoordelijkheid. Juist in een tijd van grote polarisatie zouden zij dat mee moeten wegen in hun ontwerp. Technisch is het in ieder geval zonder meer gemakkelijk om te doen. Vraag je je dus eens af: nemen deze bedrijven hun verantwoordelijkheid? Zouden de regels van de AI Act gaan helpen (zie paragraaf 9.5)?
#9.5.4Algoritmes, AI en discriminatie - concepten worden vaak verward
Over bias en mogelijke discriminatie weet je inmiddels al aardig wat in het licht van ontwikkeling en toepassing van generatieve AI. Maar een ander belangrijk aspect van algoritmes is discriminatie. We gebruiken hierbij als voorbeeld het studiebeursfraudeschandaal bij de Dienst Uitvoering Onderwijs (DUO) (NOS, 2023).
Bij DUO werden namelijk tussen 2012 en 2023 studenten gecontroleerd via een algoritme met zelfbedachte risicocriteria zoals leeftijd en opleidingsniveau. Hoewel er geen sprake was van directe discriminatie (rechtstreeks selecteren op migratieachtergrond), was er wel indirecte discriminatie door selectie op kenmerken als leeftijd, onderwijssoort (mbo kreeg een hogere risicoscore dan hbo of universiteit) en afstand tot de ouder(s), waardoor meer studenten met een niet-Europese migratieachtergrond werden geselecteerd voor een controle dan andere studenten.
Het hoofdprobleem is de onevenredigheid in wie er op voorhand werd gecontroleerd op basis van ‘niet objectieve rechtvaardiging’ voor de risicocriteria. De criteria waren namelijk bedacht op basis van ‘indrukken’. Zelfs als sommige gecontroleerde studenten daadwerkelijk hadden gefraudeerd, is het discriminerend als bepaalde groepen disproportioneel vaak worden gecontroleerd op basis van onterecht veronderstelde risico's. Dat is in strijd is met gelijkheidsbeginsels en anti-discriminatiewetgeving. Het tweede probleem is dat - als fraude werd vastgesteld bij de geselecteerde groep - er een zelfversterkend effect op zou treden: er zou namelijk worden vastgesteld dat onevenredig veel studenten met een migratieachtergrond fraude zouden hebben gepleegd binnen het totale bestand van DUO. Zo zouden hun zelfbedachte criteria worden bekrachtigd en er zou een vicieuze cirkel ontstaan.
Het interessante van deze casus is dat in de vele artikelen die hierover zijn geschreven, de woorden ‘discriminatie’, ‘AI’ en ‘algoritmes’ in een adem genoemd werden. Je zou erdoor kunnen denken dat ze allemaal hetzelfde betekenen. Terwijl discriminatie in het geval van DUO niets te maken had met AI of generatieve AI.
#9.6Privacy en gegevensbescherming - begrip van de wetten
De Europese Unie heeft met de AI Act en de Algemene Verordening Gegevensbescherming (AVG) twee belangrijke wettelijke kaders gemaakt om je als student en burger te beschermen. De AVG bevat strikte regels over het verzamelen en verwerken van je persoonsgegevens, waarbij transparantie, doelstelling en minimale gegevensverwerking centraal staan. De AI Act voegt hier specifieke regels aan toe voor AI-systemen, ingedeeld in risicocategorieën met bijbehorende verplichtingen. Hoge risicotoepassingen moeten aan strenge eisen voldoen op het gebied van transparantie, menselijk toezicht en verantwoording. Bepaalde AI-praktijken die je fundamentele rechten bedreigen zijn volledig verboden, zoals gezichtsherkenning in openbare ruimtes. De instelling waar je studeert of het bedrijf waar je werkt, is ervoor verantwoordelijk om op een rechtmatige manier hiermee om te gaan, zodat je met systemen kan werken die voldoen aan de eisen.
Ondanks deze wettelijke bescherming heb je als gebruiker ook een eigen verantwoordelijkheid in het beschermen van jouw privacy en die van anderen. Het begint natuurlijk met het beveiligen van je eigen computer, goede wachtwoorden gebruiken en waar mogelijk versleuteling van je gegevens. Gaat het om generatieve AI dan start je met kritisch te beoordelen welke AI-diensten je gebruikt en welke gegevens je daarbij deelt. Het is bijvoorbeeld heel gemakkelijk om een gratis account te maken bij een generatieve AI-dienst, maar weet je dan wat er met jouw gegevens gebeurt? Je kunt bijvoorbeeld regelmatig de toestemmingen controleren en waar mogelijk alternatieven gebruiken die minder van je data verzamelen. Wees je bewust van de waarde van je persoonlijke gegevens en blijf kritisch over ‘gratis’ diensten die in feite worden betaald met jouw data. Deel daarom in dat soort systemen nooit bijzondere gegevens of gevoelige gegevens. Door zowel gebruik te maken van de wettelijke bescherming als je eigen persoonlijke waakzaamheid kun je de voordelen van AI benutten zonder te veel privacy op te offeren.
#9.7Macht van Big Tech
Generatieve AI is een technologie die een fundamentele machtsverschuiving in de digitale wereld veroorzaakt. Aan het roer van deze verschuiving staan de grote technologiebedrijven - vaak aangeduid als Big Tech - zoals OpenAI (met investeringen van Microsoft), Google, Amazon, Meta en Apple. Deze bedrijven beschikken niet alleen over enorme hoeveelheden data en rekenkracht, maar ook over de financiële middelen, de netwerken en infrastructuur om generatieve AI op wereldschaal te ontwikkelen en uit te rollen. De ontwikkeling van grote taalmodellen, zoals GPT-4, Gemini en Claude, vereist investeringen van honderden miljoenen dollars, wat de drempel voor kleinere bedrijven of publieke instellingen erg hoog maakt. En deze machtsconcentratie gaat versneld door (Verhagen, 2025).
Slechts een handvol bedrijven bepaalt welke sociale media er zijn, welke algoritmes ze inzetten, en welke AI-modellen wereldwijd worden gebruikt, op welke infrastructuur het draait, onder welke voorwaarden en met welke ethische implicaties. Deze eenzijdige concentratie van middelen leidt tot een centralisatie van macht. Een belangrijk aspect daarvan is bijvoorbeeld het wegkapen van bezoekers van websites, met name journalistieke websites. Doordat mensen meer en meer gaan zoeken op het internet met behulp van generatieve AI (als jonge mensen het al niet doen via YouTube, TikTok of Instagram), bezoeken mensen minder en minder de websites waar de grote bedrijven de data vandaan halen. Bij het zoeken blijven mensen hangen op het antwoord van de AI zonder nog de originele website te bezoeken waardoor die websites veel inkomsten missen. Volgens The Atlantic (Reisner, 2025), kan dat binnenkort al betekenen dat vele journalistieke websites verdwijnen, terwijl die cruciaal zijn voor een democratie omdat ze burgers informeren, controle uitoefent op de overheid en een platform bieden voor publiek debat.
De Europese Commissie en andere beleidsorganen waarschuwen al langer dat deze technologische dominantie risico’s meebrengt voor democratische controle, transparantie en eerlijke toegang tot informatie en innovatie (Bietti, 2020; Crawford, 2021c). Zo bepalen big tech-bedrijven vaak eenzijdig welke data in de modellen worden opgenomen, welke talen en culturele contexten dominant zijn, wie toegang krijgt tot geavanceerde modellen. Dit heeft directe gevolgen voor bijvoorbeeld onderwijs, media, en publieke dienstverlening, die steeds vaker afhankelijk raken van door bedrijven geleverde AI-systemen.
De mondiale machtsdynamiek rond AI wordt momenteel dus meer en meer bepaald door economische en geopolitieke belangen. Terwijl de Verenigde Staten een voorsprong hebben op het gebied van private AI-innovatie, wil China via staatsgestuurde projecten deze voorsprong inhalen. Europa probeert zich te positioneren als hoeder van ethische en transparante AI, maar is daarbij sterk afhankelijk van buitenlandse technologie en platforms. Deze asymmetrie maakt het lastig voor Europese overheden en instellingen om werkelijk soevereine keuzes te maken over hoe AI wordt ingezet in bijvoorbeeld het onderwijs, de zorg of justitie (Mazzucato, 2021). De zorgen over digitale kolonisatie - waarbij technologieën niet alleen worden ingevoerd, maar ook de waarden en economische verhoudingen van de producenten meebrengen - nemen daardoor toe (Couldry & Mejias, 2019).
De dominantie van big tech in generatieve AI roept ook ethische vragen op over inclusie, rechtvaardigheid en de rol van de publieke sector. Het afgelopen jaar hebben de eigenaren van Facebook en -Instagram (Meta van Mark Zuckerberg), Tesla, X en Grok (Elon Musk) en anderen (TikTok, Google), zich openlijk tegen diversiteitsbeleid verzet. En dat vertaalt zich direct wereldwijd.
Wie wordt er betrokken bij het ontwikkelen van deze technologieën? Welke stemmen blijven ongehoord? En welke kennisdomeinen worden versterkt of juist genegeerd door de datasets waarop de modellen worden getraind? Deze vragen raken aan de kern van digitale soevereiniteit en het recht op technologie die in dienst staat van de samenleving, niet slechts van aandeelhouders.
Om de machtspositie van big tech tegenwicht te bieden, groeit de vraag naar publieke investeringen in open en transparante AI-modellen, bijvoorbeeld via universiteiten, bibliotheken of internationale samenwerkingen zoals de European AI Alliance (European Commission, 2018). Dergelijke initiatieven kunnen bijdragen aan een meer evenwichtige en democratisch gelegitimeerde AI-toekomst, mits ze gepaard gaan met structurele financiering, heldere regelgeving en brede maatschappelijke betrokkenheid (Brundage et al., 2020; Eubanks, 2018). Initiatieven zoals Hugging Face, EleutherAI en BLOOM pleiten voor open toegang tot AI-modellen, datasets en trainingsprocedures. Hiermee proberen ze technologische onafhankelijkheid en inclusie te bevorderen. Toch blijven deze projecten afhankelijk van fondsen van overheden of, toch weer big tech zelf (Kreps & Kriner, 2023).
#9.8Open source modellen versus gesloten modellen
Open source LLM’s en gesloten modellen LLM’s verschillen in hun benadering van toegankelijkheid en gebruik. Open source modellen, zoals Llama, Falcon en Mistral, bieden transparantie doordat hun code, trainingsproces en vaak ook gewichten openbaar toegankelijk zijn. Dit maakt het mogelijk voor onderzoekers en ontwikkelaars om de modellen te bestuderen, aan te passen, te verbeteren en daarin samen te werken. Het verbetert de inzichtelijkheid in de werking van de systemen. Bovendien kunnen open source modellen lokaal worden uitgevoerd (draaien op een gebruikerscomputer), waardoor ze meer privacy-vriendelijk kunnen zijn en minder afhankelijk van externe diensten.
Maar open source modellen hebben vaak wel beperktere middelen voor training en verfijning, wat kan resulteren in minder geavanceerde capaciteiten. Zo bieden gesloten modellen zoals GPT-4/5 en Claude meestal betere prestaties en betrouwbaarheid. Maar de gesloten aard beperkt de wetenschappelijke vooruitgang omdat onderzoekers geen inzicht krijgen in hoe de modellen werken of beslissingen nemen. De keuze tussen open source en gesloten LLM’s komt dus neer op een afweging tussen transparantie, controle en innovatie door samenwerking tegenover prestaties en professionele ondersteuning.
9.9Zelfstudievragen
9.9.1Checkvragen
- Welke drie opvallende categorieën van databronnen werden gevonden in de mC4-dataset die gebruikt wordt voor het trainen van taalmodellen zoals ChatGPT?
- Wat is het verschil tussen echokamers en filterbubbels, en hoe kunnen algoritmes bijdragen aan polarisatie en extremisme?
- Noem drie belangrijke verschillen tussen open source LLM’s (zoals Llama en Mistral) en gesloten modellen (zoals GPT-5 en Claude).
9.9.2Reflectievragen
- Het hoofdstuk beschrijft hoe datalabelers vaak onder slechte arbeidsomstandigheden werken voor lage lonen. Hoe verhoud jij je tot het gebruik van AI-tools waarvan je weet dat ze mogelijk gebaseerd zijn op uitbuiting van werknemers? Wat voor afwegingen maak je hierin?
- Big Tech-bedrijven hebben door hun dominantie in AI-ontwikkeling veel macht over welke waarden en perspectieven in AI-modellen worden opgenomen. Hoe zou volgens jou een meer democratische en eerlijke ontwikkeling van AI eruit kunnen zien, en welke rol zie je hierin voor jezelf als toekomstige professional?
9.9.3Antwoordsuggesties
- De drie opvallende categorieën zijn: DocPlayer (een website die automatisch documenten verzamelt, vaak zonder toestemming en met persoonsgegevens), krantenartikelen van uitgeverijen (die nooit toestemming gaven voor dit gebruik), en bronnen van lage kwaliteit waaronder zelfs nazistische websites zoals Stormfront.
- Echokamers ontstaan wanneer je vooral interacteert met content die je wereldbeeld bevestigt, waardoor het algoritme je nog meer van ditzelfde soort content laat zien. Filterbubbels zijn het gevolg: je wordt systematisch minder blootgesteld aan afwijkende meningen. Algoritmes versterken dit door groepspolarisatie (extremere standpunten in groepen), bevestigingsbias en het wegfilteren van tegengestelde meningen.
- Open source modellen bieden transparantie in code en trainingsproces, kunnen lokaal uitgevoerd worden (meer privacy), maar hebben vaak beperktere middelen. Gesloten modellen presteren meestal beter en hebben professionele ondersteuning, maar bieden geen inzicht in werking en beperken wetenschappelijke vooruitgang door hun ondoorzichtigheid.
- Dit is een persoonlijke reflectievraag waarbij je kunt overwegen: je bewustwording van de arbeidsomstandigheden, alternatieven zoeken (zoals lokale LLM’s of ethische aanbieders), transparantie-eisen van bedrijven, of accepteren van beperkingen in AI-gebruik om uitbuiting te vermijden.
- Mogelijke elementen: publieke investeringen in open AI-onderzoek, democratische betrokkenheid bij AI-ontwikkeling, diversiteit in ontwikkelteams, transparantie-eisen, Europese of internationale samenwerking, en je eigen rol als kritische gebruiker die bewuste keuzes maakt en pleit voor verantwoorde AI-ontwikkeling.